
مقاله
آزمونهای آماری در پایتون با NumPy و SciPy | راهنمای کامل برای پایاننامه و پژوهشهای علمی
اهمیت تحلیل های آماری در پژوهش های دانشگاهی
انجام دقیق تحلیل های آماری یکی از ارکان اصلی در اعتباربخشی به نتایج پژوهش ها و رساله های دانشگاهی است. امروزه زبان برنامه نویسی پایتون به دلیل داشتن ابزارهای قدرتمند، جایگاه ویژه ای در میان محققان پیدا کرده است. در این میان، کتابخانه های NumPy و SciPy به عنوان پایه های اصلی محاسبات علمی و آماری شناخته می شوند. در این مقاله قصد داریم نحوه پیاده سازی آزمون های آماری مختلف را با استفاده از این ابزارها بررسی کنیم تا پژوهشگران در مسیر انتخاب موضوع پایان نامه کارشناسی ارشد و تحلیل داده های خود با چالش کمتری مواجه شوند.
نقش NumPy در محاسبات عددی و آماری پایتون
کتابخانه NumPy یک کتابخانه شخص ثالث برای محاسبات عددی است که برای کار با آرایه های تک بعدی و چند بعدی بهینه شده است. نوع آرایه اولیه آن ndarray نام دارد و شامل روال های زیادی برای تحلیل آماری است. برای بررسی دقیق تر داده های پژوهشی، می توانید از راهنمای دانلود نمونه پایان نامه نیز بهره بگیرید. این کتابخانه بستر مناسبی را برای پردازش حجم انبوهی از داده های عددی فراهم می کند که پیش نیاز اصلی هرگونه تحلیل آماری دقیق در پژوهش های علمی است.
معرفی کتابخانه SciPy و ماژول scipy.stats
کتابخانه SciPy یک کتابخانه برای محاسبات علمی مبتنی بر NumPy است که عملکردهای بیشتری از جمله scipy.stats را برای تجزیه و تحلیل آماری ارائه می دهد. این کتابخانه طیف گسترده ای از توابع را برای انجام تست های فرضیه، محاسبه فاصله های اطمینان، رگرسیون خطی و تجزیه و تحلیل واریانس (ANOVA) فراهم می کند.
مفهوم معناداری آماری و مقدار P
معناداری آماری به این معنی است که نتیجه حاصل به خاطر دلیلی است که پشت سر آن وجود دارد و بر اساس شانس یا تصادف حاصل نشده است. در تست های آماری، اگر مقدار P (P-value) کمتر یا مساوی مقدار آلفا باشد، فرضیه صفر رد می شود و داده ها به لحاظ آماری معنادار در نظر گرفته می شوند؛ در غیر این صورت فرضیه صفر پذیرفته می شود. همچنین در آزمون یک طرفه (one-tailed test)، فرضیه ما تنها یک طرف مقدار را تست می کند.
پیاده سازی آزمون های کلیدی در SciPy
کتابخانه SciPy ماژول scipy.stats را جهت انجام تست های معناداری معرفی کرده است. در ادامه به برخی از مهم ترین آزمون ها اشاره می کنیم:
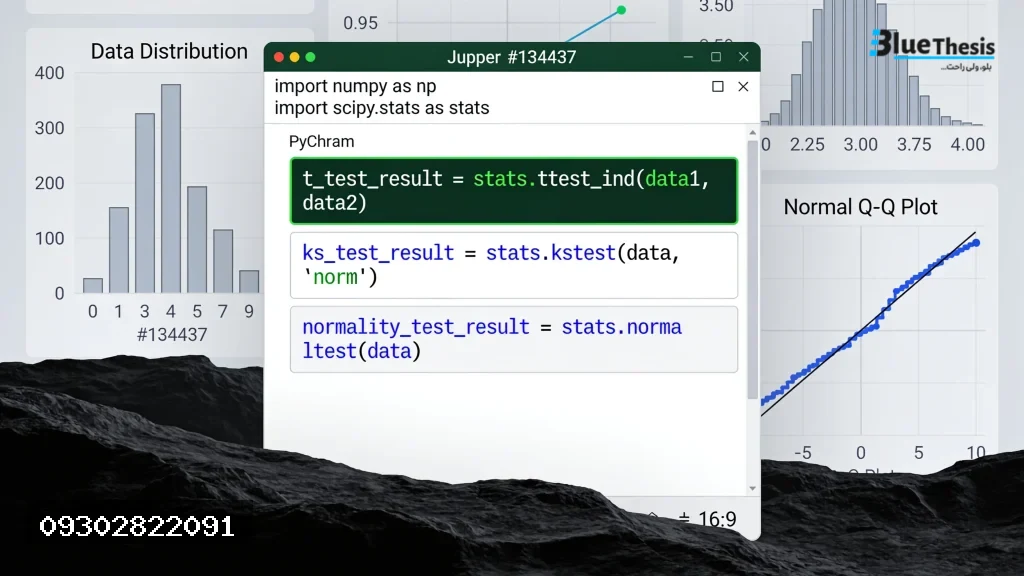
- آزمون T (T-Test): آزمون T جهت تعیین وجود تفاوت معنادار بین میانگین دو متغیر استفاده می شود و تابع
ttest_ind()دو نمونه هم اندازه را گرفته و تاپلی شامل t-statistic و p-value برمی گرداند. برای مشاهده تنها مقدار P در نتیجه خروجی آزمون T می توان از خصوصیتpvalueاستفاده کرد. همچنین برای تحلیل های تکمیلی می توانید به پرسش و پاسخ تخصصی مراجعه کنید. - آزمون کولموگروف-اسمیرنف (KS Test): آزمون KS بررسی می کند که آیا مقادیر داده شده از یک توزیع پیروی می کنند یا خیر و به عنوان پارامتر ورودی مقداری که می خواهیم تست شود را همراه با CDF به تابع می گیرد.
- آزمون نرمال بودن (Normality Test): آزمون نرمال بودن بر اساس چولگی و کشیدگی است و تابع
normaltest()مقدار P را برای فرضیه صفر مبنی بر تعلق داده ها به توزیع نرمال برمی گرداند.
بررسی توصیفی داده ها با تابع describe
پیش از انجام آزمون های استنباطی، بررسی توصیفی داده ها اهمیت بالایی دارد. تابع describe() در SciPy خلاصه ای شامل تعداد مشاهدات (nobs)، کمینه و بیشینه، میانگین، واریانس، چولگی (skewness) و کشیدگی (kurtosis) را برمی گرداند.
نتیجه گیری و دریافت خدمات تخصصی تحلیل داده
تسلط بر کتابخانه های پایتون نظیر NumPy و SciPy به پژوهشگران کمک می کند تا تحلیل های آماری پیچیده خود را با دقت بالا انجام دهند. با این حال، پیاده سازی این کدها و تفسیر نتایج آن ها در قالب فصل چهارم پژوهش، نیاز به تخصص و تجربه کافی دارد. محققانی که در زمینه تحلیل های آماری یا پیاده سازی کدهای خود نیاز به راهنمایی دارند، می توانند مقالات مرتبط مانند راهنمای جامع تحلیل داده های پیمایشی و پرسشنامه در پایتون را مطالعه کنند.
اگر پیادهسازی کد آزمونها در پایتون برایتان زمانبر است، صفحه انجام برنامه نویسی پروژههای دانشجویی و صفحه انجام تحلیل آماری را هم ببینید.