
مقاله
راهنمای کامل بررسی نرمال بودن دادهها در پایاننامه (با روشهای گرافیکی و آماری)
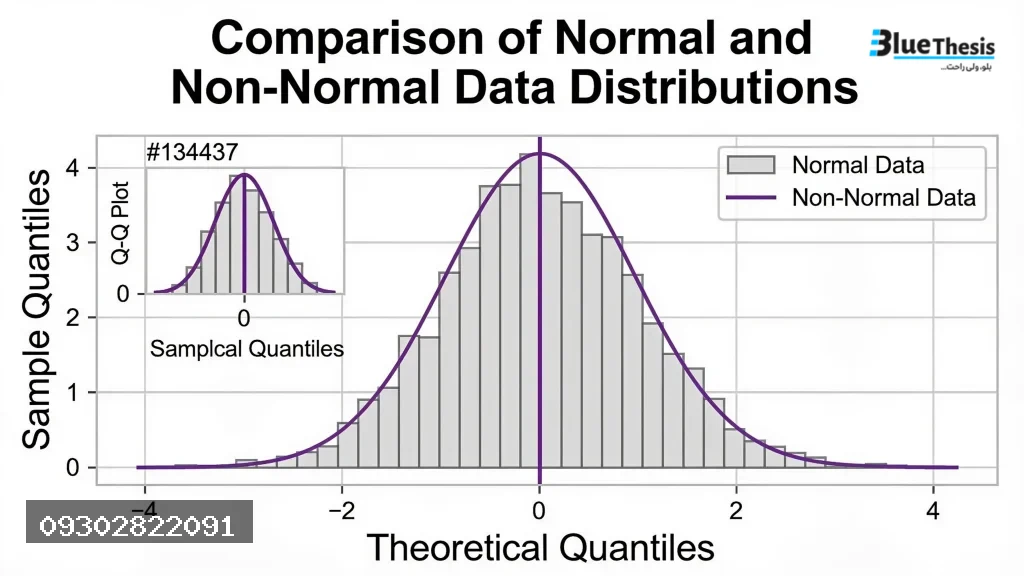
در پژوهشهای آماری و تحلیل دادهها، یکی از مراحل حیاتی قبل از انجام آزمونهای پارامتریک مانند t-test، ANOVA و رگرسیون خطی، بررسی نرمال بودن توزیع دادهها است. توزیع نرمال (گوسین) شکلی زنگولهای دارد و دادهها به صورت متقارن حول میانگین توزیع شدهاند و فاقد چولگی یا کشیدگی شدید هستند. استفاده از آزمونهای پارامتریک در شرایطی که دادهها نرمال نیستند، میتواند منجر به نتیجهگیریهای نادرست، افزایش خطاهای Type I و Type II شود. در این مقاله، روشهای بررسی نرمال بودن دادهها و راهکارهای مقابله با دادههای غیرنرمال را به صورت کامل بررسی میکنیم.
برای ارتقای کیفیت پژوهش و تحلیلهای آماری خود، استفاده از راهنماییهای تخصصی در زمینه راهنمای کامل تحلیل دادههای پرسشنامه با R بسیار سودمند است.
چرا بررسی نرمال بودن دادهها اهمیت دارد؟
چرا بررسی نرمال بودن دادهها اینقدر مهم است؟ زیرا بسیاری از آزمونهای آماری پارامتریک، مانند t-test و ANOVA، بر اساس فرضیه نرمال بودن دادهها طراحی شدهاند. اگر دادهها نرمال نباشند، نتایج آزمونها ممکن است غیرقابل اعتماد باشند. به عنوان مثال، در پایاننامههای کارشناسی ارشد، اگر دادههای جمعآوریشده از آزمونهای آماری پارامتریک استفاده کنند و دادهها نرمال نباشند، ممکن است به اشتباه فرضیههای پژوهش پذیرفته یا رد شوند.
برای تسلط بیشتر بر ابزارهای تحلیل، مطالعه مقاله راهنمای جامع تحلیل عاملی اکتشافی و تأییدی در SPSS و Amos پیشنهاد میشود.
روشهای بررسی نرمال بودن دادهها
روشهای بررسی نرمال بودن دادهها به دو دسته اصلی تقسیم میشوند: گرافیکی و آماری. در ادامه هر یک از این روشها را به تفصیل بررسی میکنیم.
روشهای گرافیکی
این روشها شامل استفاده از نمودارهای مختلفی هستند که به صورت بصری امکان بررسی توزیع دادهها را فراهم میکنند:
- هیستوگرام: این نمودار توزیع دادهها را به صورت ستونهای متوالی نمایش میدهد. اگر دادهها نرمال باشند، شکل هیستوگرام شبیه به یک زنگوله خواهد بود.
- نمودار Q-Q Plot: این نمودار دادههای نمونه را با توزیع نرمال مقایسه میکند. اگر دادهها نرمال باشند، نقاط روی نمودار روی یک خط مستقیم قرار میگیرند.
- Box Plot: این نمودار دادهها را به صورت گروهبندی شده نمایش میدهد و امکان بررسی وجود دادههای پرت (Outliers) و چولگی را فراهم میکند.
روشهای آماری
این روشها شامل آزمونهای آماری هستند که به صورت عددی نرمال بودن دادهها را بررسی میکنند:
- آزمون کولموگروف-اسمیرنوف (Kolmogorov-Smirnov Test): در این آزمون، فرضیه صفر (H0) بیانگر نرمال بودن دادهها است. اگر مقدار Sig بزرگتر از 0.05 باشد، فرض نرمال بودن پذیرفته میشود.
- آزمون شاپیرو-ویلک (Shapiro-Wilk Test): این آزمون نیز مشابه آزمون کولموگروف-اسمیرنوف عمل میکند و برای نمونههای کوچکتر دادهها مناسبتر است. اگر Sig > 0.05 باشد، دادهها نرمال در نظر گرفته میشوند.
جهت بررسی ساختارهای معادلات ساختاری در پژوهش خود، میتوانید به مقاله تحلیل و مدل سازی معادلات ساختاری مراجعه کنید.
راهکارهای مقابله با دادههای غیرنرمال
اگر دادهها غیرنرمال باشند، چند راهکار برای مقابله با این مشکل وجود دارد:
- تبدیل دادهها: استفاده از تبدیلهای ریاضی مانند لگاریتم، جذر یا معکوس میتواند توزیع دادهها را به سمت نرمال تغییر دهد.
- استفاده از آزمونهای ناپارامتریک: اگر تبدیل دادهها امکانپذیر نباشد، میتوان از آزمونهای ناپارامتریک مانند من-ویتنی (به جای t-test) یا کروسکال-والیس (به جای ANOVA) استفاده کرد.
- حذف دادههای پرت (Outliers): دادههای پرت میتوانند توزیع دادهها را غیرنرمال کنند. حذف یا اصلاح این دادهها میتواند به بهبود نرمال بودن کمک کند.
توصیههای کاربردی برای پژوهشگران
پژوهشگران تحصیلات تکمیلی، به ویژه در مرحله نهاییسازی فصل چهارم پایاننامه، باید از روشهای ترکیبی برای بررسی نرمال بودن دادهها استفاده کنند. این روشها شامل استفاده همزمان از روشهای گرافیکی و آماری است. همچنین، اگر دادهها غیرنرمال باشند، پیش از تغییر آزمون به ناپارامتریک، میتوان از تبدیلهای ریاضی استفاده نمود.
برای رفع مشکلات نگارشی و ساختاری در فصلهای پژوهش، مطالعه مقاله بررسی نگارشی مقاله و پایان نامه با گرامرلی (Grammarly) بسیار کاربردی خواهد بود.
اگر پس از بررسی نرمال بودن، اجرای آزمونهای اصلی فصل چهارم برایتان دشوار است، صفحه انجام تحلیل آماری و راهنمای انجام پروژه آماری با SPSS را ببینید.